Български
Тема
Днес ще се научите да:
+, *, in, len, min, max;range за поредици от числа;UNION, INTERSECT и EXCEPT в SQL - по начина на Python.От SQL към Python - един и същ въпрос, по два начина. Кои клиенти нямат кредити?
SELECT client_id FROM clients
EXCEPT
SELECT client_id FROM loans;all_clients = set()
with open("data/clients.csv", encoding="utf-8") as file:
file.readline() # skip the header
for line in file:
all_clients.add(line.split(",")[0]) # the 1st column: client_id
with_loans = set()
with open("data/loans.csv", encoding="utf-8") as file:
file.readline()
for line in file:
with_loans.add(line.split(",")[1]) # the 2nd column: client_id
without_loans = all_clients - with_loans # EXCEPT
print(len(all_clients), "clients,", len(with_loans), "with loans")
print(sorted(without_loans))В занятие 2 използвахме for върху strings, lists и ranges. Всички те са поредици (sequences): контейнери, които пазят подредена колекция от стойности. Основните типове поредици:
| Тип | Пример | Може ли да се променя? |
|---|---|---|
list | ["mortgage", "consumer", "overdraft"] | да |
tuple | ("L000001", "investment", 1044231.30) | не |
range | range(1, 13) | не |
str | "L000001" | не |
products = ["mortgage", "consumer", "credit_card", "consumer", "overdraft"]   # a list
record = ("L000001", "investment", 1044231.30)                                # a tuple
months = range(1, 13)                                                         # a range
loan_id = "L000001"                                                           # a string

for value in [products, record, months, loan_id]:
print(type(value).__name__, len(value))Всеки елемент на поредицата има номер - своята позиция, или индекс. Индексът започва от 0.
Python брои от 0, SAS - от 1
Първият символ на string: SUBSTR(loan_id, 1, 1) в SAS и SQL, но loan_id[0] в Python. Първият елемент на SAS array е arr{1}; на Python list е items[0]. Това е най-честата грешка през първите седмици - броете внимателно.
Всички поредици поддържат едни и същи общи операции - учите ги веднъж:
| Операция | Пример | Резултат |
|---|---|---|
| дължина | len(s) | броят елементи |
| индексиране | s[0], s[-1] | първият, последният елемент |
| slicing | s[1:3] | част от поредицата |
| конкатенация | s + t | двете, съединени (не за range) |
| повторение | s * 3 | три пъти (не за range) |
| принадлежност | x in s, x not in s | True / False |
| минимум, максимум | min(s), max(s) | най-малкият, най-големият елемент |
| броене | s.count(x) | колко пъти x е в s |
| търсене | s.index(x) | индексът на първия x |
Всеки тип има и собствени методи: lists могат да се сортират и променят, strings могат да станат с главни букви. Reference: Common sequence operations.
List е променяема (mutable) поредица от стойности:
Lists са контейнерът за всичко в Python. List е близо до колона на таблица или до SAS array - но може да расте и живее в паметта.
List се пише в квадратни скоби, с елементи, разделени със запетаи:
empty = []
stages = [1, 2, 3]
products = ["mortgage", "consumer", "credit_card"]
loan = ["L000001", "investment", 1044231.30, 8.83]     # different types
matrix = [                                             # a list of lists (session 5)
    [1, 2, 3],
    [4, 5, 6],
]
print(empty, stages, products)
print(loan)
print(len(products), len(empty), len(matrix))item = list_name[index]fruits = ["apple", "banana", "strawberry", "banana", "orange"]
print(fruits[0]) # the first item: apple
print(fruits[2]) # the third item: strawberry
print(fruits[-1]) # the last item: orangeИндекс, който не съществува, е грешка:
fruits = ["apple", "banana", "strawberry"]
print(fruits[3]) # 3 items: the indexes are 0, 1, 2list_name[index] = valuefruits = ["apple", "banana", "strawberry"]
fruits[1] = "plum" # change the second item
print(fruits)
fruits[-1] = "orange" # change the last item
print(fruits)del премахва елемент по индекса му:
fruits = ["apple", "plum", "orange"]
del fruits[1]
print(fruits)List е естественото нещо за обхождане: for взема елементите му един по един, по ред. Всичко от занятие 2 работи и тук - акумулатори, break с флаг и continue.
Сума, брой и най-големият елемент в един цикъл - като SUM, COUNT с условие и MAX в SQL:
amounts = [1044231.30, 651927.30, 644.25, 14286.75, 3200.00]

total = 0.0
count_small = 0
largest = amounts[0]                 # start with the first item
for amount in amounts:
    total += amount
    if amount < 10000:
        count_small += 1
    if amount > largest:
        largest = amount

print(f"total {total:,.2f}, average {total / len(amounts):,.2f}")
print(count_small, "small loans; the largest is", largest)
print(sum(amounts), max(amounts)) # the built-in functions do it too (section 4)Намерете елемент: спрете при първото съвпадение с break и запомнете с флаг дали е намерен (занятие 2):
watch_list = ["L000012", "L000025", "L000059"]
loan_id = "L000025"

found = False
for item in watch_list:
    if item == loan_id:
        found = True
        break

if found:
    print(loan_id, "is on the watch list")
else:
print(loan_id, "is not on the watch list")Пробвайте
Сменете loan_id на "L000099" и предскажете резултата, преди да изпълните кода. (За просто "има ли го?" loan_id in watch_list е по-кратко - раздел 4.)
Прескочете елементите, които не искате, с continue - тук липсващите стойности на колона, прочетена от файл, които са празни strings:
ratings = ["3", "", "7", "2", "", "10"]

known = 0
total = 0
for rating in ratings:
    if rating == "":                # a missing value: skip it
        continue
    known += 1
    total += int(rating)

print(known, "known ratings, the average is", total / known)Цикълът дава елементите, не позициите им. Ако ви трябва позицията, бройте я сами (занятие 5 показва enumerate, който го прави вместо вас):
amounts = [800.0, 0.0, 15900.0, 0.0]

position = 0
for amount in amounts:
    if amount == 0:
        print("a zero amount at index", position)
position += 1Два lists, един цикъл в друг - всяка двойка, като CROSS JOIN в SQL:
products = ["mortgage", "consumer"]
currencies = ["EUR", "USD"]

for product in products:
    for currency in currencies:
        print(product, currency)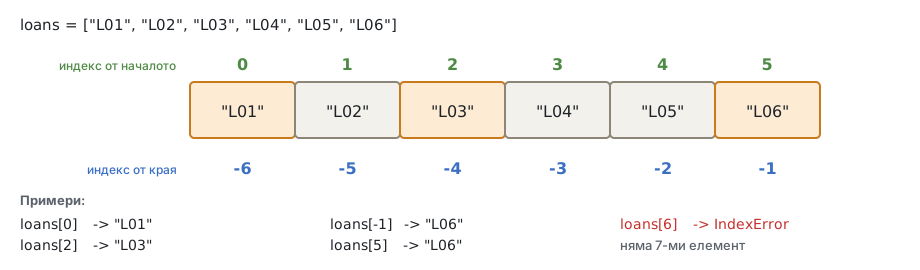
numbers = [1, 2, 3, 4, 5]
print(numbers[0], numbers[1], numbers[2], numbers[3], numbers[4])
print(numbers[-1], numbers[-2], numbers[-3], numbers[-4], numbers[-5])Отрицателните индекси са удобни за "последните": последният месец в list от месечни стойности е values[-1], каквато и да е дължината на list-а.
[start:stop:step] Slice взема част от поредица:
sequence[start:stop:step]start - индексът на първия взет елемент (включен); празно = от началото;stop - индексът, където slice-ът спира (този елемент не е включен); празно = до края;step - взема всеки n-ти елемент; празно = 1. Отрицателна стъпка върви назад.a[start:stop] items from start up to stop - 1
a[start:] items from start to the end
a[:stop] items from the beginning up to stop - 1
a[:] all items - a copy of the whole sequenceПравилото "stop не е включен" е същото като в range (занятие 2). То има хубава страна: a[:3] са първите 3 елемента, a[3:] - останалите, а a[2:5] има 5 - 2 = 3 елемента.
Лесен начин да го видите: мислете за числата на slice като за разрези между елементите, а не като за елементите. loans[1:4] реже при 1 и при 4 и взема това, което е между тях:
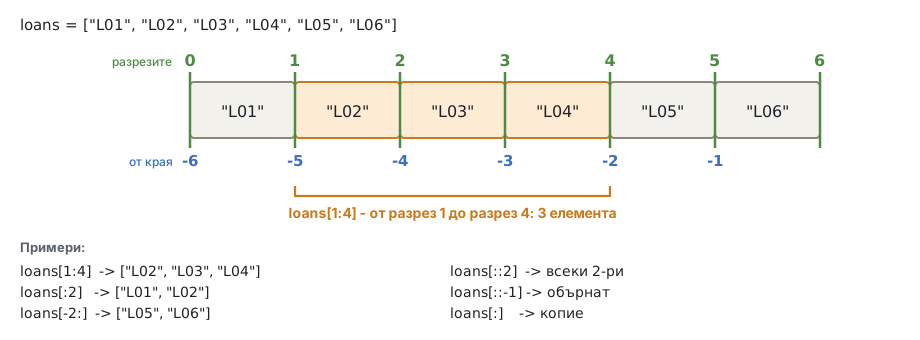
numbers = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
print(numbers[2:5])      # [2, 3, 4]
print(numbers[1:9:2])    # every 2nd item: [1, 3, 5, 7]
print(numbers[:3])       # the first 3: [0, 1, 2]
print(numbers[-3:])      # the last 3: [7, 8, 9]
print(numbers[::-1])     # all, reversed
numbers_copy = numbers[:]
print(numbers_copy)С отрицателна стъпка slice-ът върви назад, затова start трябва да е по-големият индекс. За работа с данни ви трябва [::-1] (всичко, наобратно).
numbers = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
print(numbers[:-4:-1])   # the last 3, reversed: [9, 8, 7]
print(numbers[7:2:-1])   # from index 7 down to index 3: [7, 6, 5, 4, 3]
print(numbers[2:7:-1]) # [] - you cannot go down from 2 to 7Slice никога не дава IndexError - извън границите просто взема каквото има:
numbers = [0, 1, 2]
print(numbers[1:100])
print(numbers[5:10])SUBSTR от SAS / SQL String е поредица от символи, така че същите индекси и slices работят - това е версията на Python на SUBSTR от SAS и SQL:
| SAS / SQL | Python |
|---|---|
SUBSTR(loan_id, 1, 1) | loan_id[0] |
SUBSTR(loan_id, 2) | loan_id[1:] |
SUBSTR(report_date, 1, 4) | report_date[:4] |
SUBSTR(report_date, 6, 2) | report_date[5:7] |
greeting = "Hello, World!"
print(greeting[1:5])            # 'ello'

loan_id = "L000123"
print(loan_id[0], loan_id[1:], int(loan_id[1:]))

report_date = "2026-09-30"
year, month, day = report_date[:4], report_date[5:7], report_date[8:]
print(year, month, day)Strings не могат да се променят: loan_id[0] = "X" е грешка. Методите на strings (занятие 7) правят нови strings.
Същото в pandas
pandas (занятие 14) използва същите правила. iloc взима редове и колони по позиция - от 0, без stop; .str[...] взима един и същ slice от всеки текст в колоната:
import pandas as pd

loans = pd.read_csv("data/loans.csv")
print(loans.iloc[:3, :4])                     # the first 3 rows, the first 4 columns
print(loans["start_date"].str[:4].head(3)) # SUBSTR(start_date, 1, 4) for every row+ и повторение * + съединява две поредици от един и същ тип в нова; * повтаря поредица. Множителят трябва да е цяло число.
num_list = [1, 2, 3]
alpha_list = ["a", "b", "c"]
print(num_list + alpha_list)      # a new list

record = ("L000001", "investment")
print(record + (1044231.30,))     # a new tuple, one item longer

print(num_list * 3)
print(alpha_list * 3)
print([0.0] * 12) # 12 months, all 0.0 - a common start valueСамо strings, lists и tuples могат да се съединяват и повтарят. range не може (но можете първо да направите list от него: list(range(3)) * 2).
+ прави нов list. Съединяването на два lists един под друг е UNION ALL в SQL или SET a b; в DATA step на SAS - например просрочените кредити от два месеца:
late_august = ["L000002", "L000014", "L000025"]
late_september = ["L000014", "L000059"]
late_both = late_august + late_september    # UNION ALL: L000014 is there twice
print(late_both)
print(len(late_both))(Раздел 12 показва UNION без повторенията.)
in, not in x in sequence е True, когато x е един от елементите - като IN (...) в SQL и SAS:
fruits = ["apple", "banana", "strawberry"]
numbers = [1, 2, 3]
print("banana" in fruits)
print("banana" in numbers)
print("banana" not in fruits)
print("banana" not in numbers)

r = range(0, 10)
print(3 in r, 21 in r)

product = "consumer"
if product in ["mortgage", "consumer", "credit_card", "overdraft"]:
print("retail")При strings in търси част от string-а: "USD" in "EUR,USD" е True.
len, min, max, sum, count, index outstanding = [1044231.30, 651927.30, 644.25, 5875.11]
print(len(outstanding))
print(min(outstanding), max(outstanding))
print(sum(outstanding))
print(sum(outstanding) / len(outstanding)) # the average
stages = [1, 2, 1, 1, 3, 2, 1]
print(stages.count(1)) # how many times 1 is in the list
print(stages.index(3)) # the index of the first 3min и max работят и върху strings (по азбучен ред, занятие 2). sum - само върху числа. index дава ValueError, когато стойността не е в list-а - първо проверете с in.
list(): list от всяка поредица list() прави нов list от елементите на всяка поредица (на всеки iterable):
l = list()                       # the same as l = []
print(l)

point3d = (4, 0, 3)
print(list(point3d))             # from a tuple

digits = range(0, 10)
print(list(digits))              # from a range

user_name = "ada byron"
print(list(user_name)) # from a string: one item per charactersplit split() (занятие 1) нарязва string на list от strings:
row = "L000002,C0132,investment,EUR,2019-04-16,2029-04-16,1977400.00,651927.30,5.44,35,2"
fields = row.split(",")
print(len(fields), fields[2], fields[-2])

text = "some words delimited by spaces"
print(text.split()) # without an argument: by spacesappend Започнете с празен list и добавяйте (append) стойност във всяка итерация. Това е версията на Python на statement-а OUTPUT от SAS: в SAS OUTPUT записва ред от DATA step-а в изходния набор от данни; в Python append добавя елемент в list-а.
late_loans = []

with open("data/loans.csv", encoding="utf-8") as file:
    file.readline()
    for line in file:
        fields = line.strip().split(",")
        if int(fields[9]) > 90:              # days_past_due
            late_loans.append(fields[0])     # loan_id

print(len(late_loans), "loans more than 90 days past due")
print(late_loans[:5], "...")data late_loans;
set loans;
if days_past_due > 90 then output;
keep loan_id;
run;| Метод | Какво прави |
|---|---|
lst.append(x) | добавя x в края |
lst.extend(other) | добавя всички елементи на other в края |
lst.insert(i, x) | вмъква x преди индекса i |
lst.pop() | премахва последния елемент и го връща |
lst.pop(i) | премахва елемента на индекс i и го връща |
lst.remove(x) | премахва първия елемент, равен на x (ValueError, ако няма такъв) |
lst.clear() | премахва всички елементи |
lst.index(x), lst.count(x) | индексът на първия x; колко x има |
lst.reverse() | обръща list-а на място |
lst.sort() | сортира list-а на място; sort(reverse=True): от най-големия |
lst.copy() | нов list със същите елементи (раздел 7) |
del lst[i], del lst[i:j] | премахва елемент, slice |
fruits = ["apple", "banana", "strawberry"]

fruits.append("plum")               # at the end
print(fruits)

fruits.insert(2, "NEW")             # before the index 2
print(fruits)

item = fruits.pop()                 # remove the last item, and get it
print(item, fruits)

item = fruits.pop(2)                # remove the item at index 2
print(item, fruits)

fruits.remove("banana")             # remove by value
print(fruits)

fruits.extend(["kiwi", "lemon"])    # add several items
print(fruits)

fruits.reverse()
print(fruits)

numbers = [1, 3, 4, 2]
numbers.sort()
print(numbers)
numbers.sort(reverse=True)
print(numbers)Още: More on lists в tutorial-а.
append или extend? a = [1, 2]
a.append([3, 4]) # one item: the list [3, 4]
print(a, len(a))
b = [1, 2]
b.extend([3, 4]) # two items: 3 and 4
print(b, len(b))Цикълът минава през list-а по позиция. Когато махнете елемент, следващият се премества на неговото място - и цикълът го прескача:
amounts = [0.0, 0.0, 500.0, 0.0]
for amount in amounts:
    if amount == 0:
        amounts.remove(amount)
print(amounts) # [500.0, 0.0] - one zero is still thereВместо това изградете нов list - същото като да запишете нов data set в SAS:
amounts = [0.0, 0.0, 500.0, 0.0]
non_zero = []
for amount in amounts:
    if amount != 0:
        non_zero.append(amount)
print(non_zero)(Занятие 5 прави същото на един ред, с list comprehension.)
None append, sort, reverse и другите променят list-а на място. Те връщат None, а не list-а. Класически бъг:
numbers = [3, 1, 2]
numbers = numbers.sort()       # wrong: sort() returns None
print(numbers)numbers.sort() сортира list-а и връща None, а numbers = ... свързва името с този None - сортираният list е загубен. Пишете само numbers.sort() или използвайте sorted() (следва).
sort() или sorted()? lst.sort() сортира този list. Има го само при lists.sorted(x) връща нов, сортиран list и не променя x. Работи върху всяка поредица: tuple, string, set, range.names = ["Maria", "Ivan", "Asen"]
sorted_names = sorted(names)
print(names) # not changed
print(sorted_names)
print(sorted("python")) # the characters of a string, sorted
print(sorted(names, reverse=True))Сортирането сравнява елементите с < (занятие 2): strings - по азбучен ред, главните букви преди малките, а смесица от числа и strings е грешка:
print(sorted(["banana", "Cherry", "apple"]))
print(sorted([3, "1", 2]))PROC SORT в SAS и ORDER BY в SQL могат да сортират по колона или по няколко. За записи, пазени като tuples, сложете колоната за сортиране първа (раздел 8, "Сортиране на записи"); общият начин е sorted(..., key=...): занятия 4 и 5.
Същото в pandas
Методите на pandas работят като sorted(): връщат нова таблица и не променят старата (занятие 14). Запазете резултата в име:
import pandas as pd

loans = pd.read_csv("data/loans.csv")
by_size = loans.sort_values("outstanding", ascending=False)   # ORDER BY outstanding DESC
print(loans["loan_id"].head(3).tolist())      # not changed
print(by_size["loan_id"].head(3).tolist()) # a new, sorted tableЗанятие 1 показа, че променливата е име, свързано с обект. При числа и strings това почти няма значение, защото те не могат да се променят. List може да се променя - и тогава това има голямо значение:
original = [1, 2, 3]
new_list = original          # not a copy: the same list has a second name

new_list[0] = 100
print(original)              # [100, 2, 3] - changed too!
print(new_list)
print(original is new_list, id(original) == id(new_list))new_list = original не копира нищо. Двете имена сочат към един и същ обект list в паметта, така че промяна през едното име се вижда през другото. is (и id()) го показва.
Анимация
Lists и референции: 1. List се променя на място, 2. Две имена, един list, 3. Копие, 4. sort() и sorted()
Когато ви трябва независим list, направете копие. Три начина дават едно и също:
original = [1, 2, 3]

copy1 = original[:]          # a slice of everything
copy2 = original.copy()      # the copy() method
copy3 = list(original)       # list() makes a new list

copy1.append(4)
print(original, copy1, copy2, copy3)
print(original is copy1)Това са плитки (shallow) копия: новият list има същите елементи. Когато елементите сами са lists (таблица като list от редове), редовете пак са общи - занятие 5 обяснява плитките и дълбоките копия.
Пробвайте
В първия пример на този раздел напишете new_list = original.copy() вместо new_list = original. Предскажете какво показват сега print(original) и original is new_list, после изпълнете кода.
Tuple е непроменима (immutable) поредица: щом е създаден, не може да се промени - не може да се добави, премахне или замени елемент.
count и index.Tuple се пише в кръгли скоби, с елементи, разделени със запетаи:
t = ()
print(type(t))              # an empty tuple

t = (99,)                   # one item: note the comma!
print(type(t), t)

t = (99)                    # without the comma, it is just 99 in brackets
print(type(t), t)

point3d = (4, 0, 3)
print(point3d)

point3d = 4, 0, 3           # the brackets may be left out
print(point3d)Запетаята прави tuple, а не скобите. Затова x, y = 1, 2 (занятие 1) работи: дясната страна е tuple.
address = ("Bulgaria", "Sofia", "Nezabravka str", 14)
country = address[0]
town = address[1]
print(country, town, address[-1])

ada_birth_date = (10, "December", 1815)
print(f"Ada was born on {ada_birth_date[1]} {ada_birth_date[0]}, {ada_birth_date[2]}")
address = ("Bulgaria", "Sofia", "Nezabravka str", 14)
address[0] = "France"За да "промените" tuple, правите нов (името се премества към него, както при числата):
record = ("L000001", "investment", 1)
record = record[:2] + (2,)          # a new tuple with stage 2
print(record)Анимация
Lists и референции: 5. Tuple не може да се променя
Tuple не може да промени кои обекти държи. Ако един от тях е list, самият list все пак може да се променя:
t = ([1, 2, 3], "fixed")
t[0][2] = 100              # change the list inside the tuple
print(t)users = (
["Ivan", "Ivanov", 34],
["Maria", "Ivanova", 36],
)
users[0][2] = 100 # the list inside: works
print(users[0])
users[0] = ["Petar", "Petrov", 45] # the tuple itself: TypeErrorСъщото важи за tuple от lists - фиксирана структура от групи, които могат да се променят отвътре:
products = (
    ["Shirt", "Pants"],      # the names
    [20, 35],                # the quantities
)
products[1][0] = 100         # a quantity can change
print(products)Анимация: 6. List вътре в tuple.
Tuple (или list) може да се разопакова в няколко имена наведнъж - броят на имената трябва да е равен на броя на елементите:
record = ("L000002", "investment", 651927.30)

loan_id, product, outstanding = record
print(loan_id)
print(product)
print(outstanding)loan_id, product = ("L000002", "investment", 651927.30) # 2 names, 3 itemsКогато ви трябват само някои от стойностите, пак ви трябва име за всяка от останалите - броят трябва да съвпада. _ е обичайното име за стойност, която не ви трябва. То е нормално име, но казва на читателя "пренебрегнато":
row = ("L000002", "C0132", "investment", "EUR", 651927.30)

loan_id, _, product, _, outstanding = row       # skip client_id and currency
print(loan_id, product, outstanding)Пробвайте
Махнете едно _ от разопаковането и предскажете грешката, преди да изпълните кода.
Име със звездичка * взема "останалото", като list:
row = ("L000002", "C0132", "investment", "EUR", 651927.30)
loan_id, client_id, *other = row
print(loan_id, client_id, other)

first, *middle, last = [1, 2, 3, 4, 5]
print(first, middle, last)

loan_id, *_ = row                               # only the first value
print(loan_id)List от tuples е малка таблица: всеки tuple е ред, всяка позиция - колона. for с разопаковане (занятие 2) я чете ред по ред:
loans = [
    ("L000001", "investment", 1044231.30, 0),
    ("L000002", "investment", 651927.30, 35),
    ("L000003", "credit_card", 644.25, 0),
    ("L000014", "consumer", 14286.75, 200),
]

print(loans[1])             # the second row
print(loans[1][2])          # its third column
print(loans[-1][0])         # the first column of the last row

for loan_id, product, outstanding, days_past_due in loans:
    if days_past_due > 30:
print(loan_id, product, outstanding)Често използване на list от tuples - етикет със стойността си - и разделянето му отново на два lists:
exposures = [("L000001", 1044231.30), ("L000002", 651927.30), ("L000003", 644.25)]

loan_ids = []
amounts = []
for loan_id, amount in exposures:
    loan_ids.append(loan_id)
    amounts.append(amount)
print(loan_ids)
print(amounts)Tuples се използват и за няколко върнати стойности на функция (занятие 4) и като ключове на dictionary (занятие 6), където list не е позволен.
Tuples се сравняват като думи, елемент по елемент: първо първите елементи; само когато са равни - вторите, и т.н. Затова sorted върху list от tuples сортира по първия елемент, после по втория - като ORDER BY col1, col2 в SQL:
print((2, "b") < (10, "a"))         # True: 2 < 10, the rest is not looked at
print((5, "b") < (5, "c"))          # True: 5 == 5, so "b" < "c" decides

pairs = [(5, "L000003"), (12, "L000001"), (5, "L000002")]
print(sorted(pairs))                # by the number, then by the id
print(sorted(pairs, reverse=True)) # from the largestЗа да сортирате записи по друга колона, изградете нови tuples с тази колона първа - най-големите експозиции:
loans = [
    ("L000001", "investment", 1044231.30),
    ("L000002", "investment", 651927.30),
    ("L000003", "credit_card", 644.25),
    ("L000014", "consumer", 14286.75),
]

by_size = []
for loan_id, product, outstanding in loans:
    by_size.append((outstanding, loan_id))      # the amount first

for outstanding, loan_id in sorted(by_size, reverse=True)[:2]:
print(loan_id, f"{outstanding:,.2f}")Два чифта скоби
by_size.append((outstanding, loan_id)): външните скоби са на извикването, вътрешните правят tuple-а. append(outstanding, loan_id) дава две стойности на append - TypeError.
В обикновен tuple loan[2] не казва коя е третата колона. Named tuple дава имена на позициите - лек запис:
from collections import namedtuple

Loan = namedtuple("Loan", ["loan_id", "product", "outstanding"])
loan = Loan("L000001", "investment", 1044231.30)

print(loan)
print(loan.outstanding)          # by name
print(loan[2])                   # still by position
loan_id, product, outstanding = loanКласовете и data classes (занятия 11 - 12) отиват по-далеч: записи, които могат и да проверяват данните си и имат собствени методи.
| List | Tuple | |
|---|---|---|
| Скоби | [1, 2, 3] | (1, 2, 3) |
| Може да се променя | да: добавяне, премахване, сортиране | не |
| Използвайте за | колекция, която расте: кредитите на един отчет, стойностите на една колона | фиксиран запис: един ред, дата, двойка |
| Памет, скорост | малко повече, малко по-бавно | малко по-малко, малко по-бързо |
import sys

as_list = [1044231.30, 651927.30, 644.25]
as_tuple = (1044231.30, 651927.30, 644.25)
print(sys.getsizeof(as_list), "bytes for the list")
print(sys.getsizeof(as_tuple), "bytes for the tuple")(Точните числа зависят от версията на Python; tuple винаги е по-малък.)
Практическо правило: list за много стойности от един и същ вид (всички номера на кредити), tuple за няколко стойности от различен вид, които са свързани (един кредит).
list() и tuple() преобразуват в двете посоки:
address = ("Bulgaria", "Sofia", "Nezabravka str", 14)
address = list(address)          # now it can change
address[3] = 25
print(address)

fruits = ["apple", "banana", "strawberry", "banana", "orange"]
print(tuple(fruits))
print(tuple(range(0, 10)))
print(tuple("ada byron"))range range дава непроменима поредица от цели числа:
range(stop)
range(start, stop)
range(start, stop, step)
stop е единственият задължителен аргумент. Числата свършват на stop - 1.start е 0, когато е пропуснат; step е 1, когато е пропуснат.step може да е отрицателен, но не и 0 (ValueError).Reference: Ranges.
print(list(range(0, 10)))        # 0 ... 9
print(list(range(10)))           # the same
print(list(range(2, 10, 2)))     # 2, 4, 6, 8
print(list(range(9, -1, -1)))    # 9 ... 0, backwards
print(list(range(-3, 4)))        # -3 ... 3
print(list(range(9, -1, 1))) # empty: you cannot go from 9 up to -1Циклите DO на SAS и техните range са в таблицата на занятие 2, раздел 10. Ново днес: range назад - do i = 10 to 1 by -1; е range(10, 0, -1).
Range пази само start, stop и step и изчислява всяко число, когато потрябва. Когато отпечатате range, виждате само "формулата". За да видите числата, направете list или tuple от него - или го обходете с цикъл:
r = range(0, 10, 2)
print(r)
print(list(r))
for i in r:
print(i, end=" ")Range от милиард числа е толкова малък в паметта, колкото range от десет - list пази всяко число:
import sys

print(sys.getsizeof(range(10)), sys.getsizeof(range(1_000_000_000)))
print(sys.getsizeof(list(range(1000)))) # a list keeps every numberlen, индекси, slices и in работят върху range, и то бързо:
r = range(0, 1_000_000, 5)
print(len(r), r[3], r[-1], 500 in r, 501 in r)
print(range(10)[:3])Set е неподредена колекция от уникални стойности - множествата от математиката.
Sets се използват за проверка на принадлежност, за премахване на повторения и за сравняване на групи: обединение, сечение, разлика (раздел 12).
Set се пише в къдрави скоби:
set_of_immutables = {"a", 1, "b", 2, 3}
print(set_of_immutables)

int_dup_numbers = {1, 2, 3, 1, 2, 4, 3, 5, 1, 2, 3}
print(int_dup_numbers)                       # the duplicates are gone
print(int_dup_numbers == {1, 2, 3, 4, 5}) # order and duplicates do not matterset_of_mutables = {[1, 2, 3], ["a", "b"]} # TypeError: a list is unhashable{} не е празен set
{} е празен dictionary (занятие 6): колекция от двойки key: value, докато set има само стойности. Празният set е set():
print(type({}), type(set()))SELECT DISTINCT от SQL В SQL SELECT DISTINCT дава всяка стойност на колона по веднъж. В SAS пишете същото в PROC SQL или използвате PROC SORT с NODUPKEY:
SELECT DISTINCT product FROM loans;proc sort data=loans(keep=product) out=products nodupkey;
by product;
run;В Python set() прави set от всяка поредица - повторенията изчезват:
l1 = [1, 2, 1, 3, 2, 5, 3]
l2 = list(set(l1))
print(l2)

products = ["consumer", "mortgage", "consumer", "overdraft", "mortgage"]
print(set(products))                 # SELECT DISTINCT product
print(len(set(products)))            # COUNT(DISTINCT product)
print(sorted(set(products))) # SELECT DISTINCT ... ORDER BYВърху данните - различните продукти в loans.csv:
products = set()
with open("data/loans.csv", encoding="utf-8") as file:
    file.readline()
    for line in file:
        products.add(line.split(",")[2])
print(len(products), sorted(products))Редът на set не се запазва
Set не помни реда, в който са дошли стойностите. Отпечатайте един и същ set от strings при две пускания на програмата и редът може да е различен. Когато редът има значение - в отчет, в тест - използвайте sorted(the_set). (За да премахнете повторенията и да запазите първоначалния ред: list(dict.fromkeys(items)), занятие 6.)
my_set = {1, 2, 3}
my_set.add(4)
print(my_set)
my_set.add(2)               # already there: nothing changes
print(my_set)
my_set.discard(3)           # remove a value (no error if it is not there)
print(my_set)len, in, min, max, sum и for работят както при lists.
remove, pop, clearremove(x) също маха x, но спира с KeyError, когато x не е в set-а. pop() маха и връща някакъв елемент (кой - не е определено), clear() изпразва set-а.
my_set = {1, 2, 3}
my_set.remove(2)
print(my_set)
my_set.remove(5) # KeyError: 5 is not therein Отвътре set е hash таблица: Python изчислява от стойността къде трябва да е тя и търси само там. List се претърсва елемент по елемент, от началото. За in върху голяма колекция set е много по-бърз; за обхождане на всички елементи и за достъп по индекс list е по-добър.
Затова, когато проверявате много стойности срещу дълъг списък от позволени кодове - номенклатура - първо сложете кодовете в set.
import time

large_list = list(range(1_000_000))
large_set = set(large_list)

start = time.perf_counter()
found = 999_999 in large_list
list_time = time.perf_counter() - start

start = time.perf_counter()
found = 999_999 in large_set
set_time = time.perf_counter() - start

print(f"in a list: {list_time:.6f} s")
print(f"in a set: {set_time:.6f} s")frozensetfrozenset е непроменим set. Понеже не може да се променя, може да бъде елемент на set или ключ на dictionary:
pairs = {frozenset({"EUR", "USD"}), frozenset({"EUR", "BGN"})}
print(frozenset({"USD", "EUR"}) in pairs) # the order does not matterUNION, INTERSECT, EXCEPT от SQL 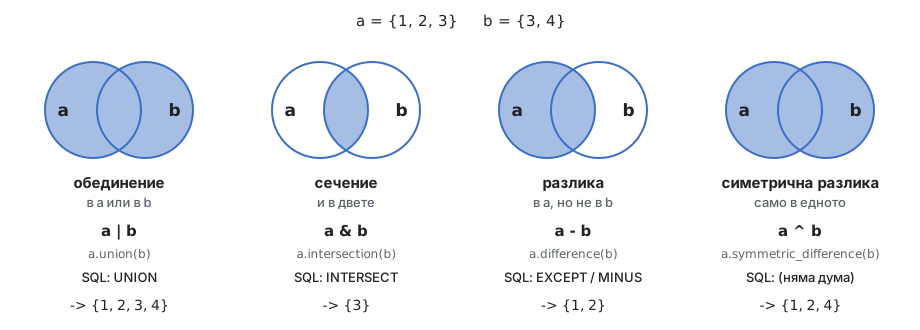
| Операция | Оператор | Метод | Резултат | SQL (и в PROC SQL на SAS) |
|---|---|---|---|---|
| обединение | a | b | a.union(b) | в a или в b | UNION |
| сечение | a & b | a.intersection(b) | и в двата | INTERSECT |
| разлика | a - b | a.difference(b) | в a, не в b | EXCEPT (в по-старите Oracle: MINUS) |
| симетрична разлика | a ^ b | a.symmetric_difference(b) | в единия от тях, но не и в двата | - |
Всяка операция връща нов set.
set1 = {1, 2, 3, 4}
set2 = {5, 4}

print(set1 | set2, set1.union(set2))
print(set1 & set2, set1.intersection(set2))
print(set1 - set2, set1.difference(set2))
print(set1 ^ set2, set1.symmetric_difference(set2))UNION или UNION ALL?
UNION в SQL премахва повторенията - това е обединение на sets, a | b. UNION ALL пази всеки ред - това е съединяване на два lists, list_a + list_b (раздел 4).
Методите приемат всяка поредица, операторите - само sets. a.isdisjoint(b) е True, когато двата set-а нямат общи елементи.
regions = {"Sofia", "Varna"}
print(regions.union(["Ruse", "Sofia"]))
print(regions.isdisjoint({"Ruse", "Pleven"}))
print(regions | ["Ruse", "Sofia"]) # TypeErrorНомерата на клиентите с кредит в края на август и в края на септември:
august = {"C0001", "C0002", "C0003", "C0005", "C0008"}
september = {"C0002", "C0003", "C0005", "C0013", "C0021"}

print("new:     ", sorted(september - august))      # EXCEPT
print("closed:  ", sorted(august - september))
print("stayed:  ", sorted(august & september))      # INTERSECT
print("all:     ", len(august | september))         # UNION
print("changed: ", sorted(august ^ september)) # new or closedПробвайте
Добавете "C0001" към september и предскажете петте реда, преди да изпълните блока.
required = {"id_card", "income_statement", "collateral_valuation", "insurance"}
submitted = {"id_card", "insurance", "bank_statement"}

print("Received:", ", ".join(sorted(required & submitted)))
print("Missing: ", ", ".join(sorted(required - submitted)))
print("Extra: ", ", ".join(sorted(submitted - required)))", ".join(...) прави един string от елементите, с ", " между тях (занятие 7).
| Проверка | Оператор | Метод |
|---|---|---|
всеки елемент на a е в b | a <= b | a.issubset(b) |
b има всеки елемент на a | b >= a | b.issuperset(a) |
Това са бързи проверки на данните, като проверките, които пишете в SQL преди join:
allowed_currencies = {"EUR", "USD"}

currencies = set()
loan_clients = set()
with open("data/loans.csv", encoding="utf-8") as file:
    file.readline()
    for line in file:
        fields = line.split(",")
        loan_clients.add(fields[1])
        currencies.add(fields[3])

clients = set()
with open("data/clients.csv", encoding="utf-8") as file:
    file.readline()
    for line in file:
        clients.add(line.split(",")[0])

print("only allowed currencies:", currencies <= allowed_currencies)
print("every loan has a known client:", loan_clients <= clients)
print("loans of unknown clients:", loan_clients - clients) # LEFT JOIN ... WHERE c.client_id IS NULLСъщото в pandas
Същата проверка на две таблици преди JOIN - със set() от колона или с isin (занятие 15; там merge(..., indicator=True) показва редовете без съвпадение):
import pandas as pd

loans = pd.read_csv("data/loans.csv")
clients = pd.read_csv("data/clients.csv")
print(set(loans["client_id"]) - set(clients["client_id"]))    # EXCEPT
print(loans["client_id"].isin(clients["client_id"]).all()) # every loan has a known clientОтворете своето копие на Homework repository във VS Code (преди занятието: вземете новите задачи) и пускайте задачите от терминала, в главната папка на repository-то:
python 03-lists-tuples-sets/practice/task1-predict-sequences.py| Задача | Файл | Какво правите |
|---|---|---|
| 1 | task1-predict-sequences.py | Предвидете 14 индекса, slices и операции, после проверете |
| 2 | task2-slices.py | Части от номера и дати; тримесечия от година месечни стойности |
| 3 | task3-list-methods.py | Списък за наблюдение: добавяне, вмъкване, премахване, сортиране, броене |
| 4 | task4-tuples.py | Записи като tuples: разопаковане, четене, сумиране; list от tuples |
| 5 | task5-sets.py | Клиентите от два месеца: нови, закрити, останали; кредитно досие |
| 6 | task6-from-file.py | От loans.csv и clients.csv: различни стойности, lists, проверки със sets |
Помощ за задачите и домашното
(99,), sort / sorted и sets искат раздели 6, 8, 11 и 12). Задача 3: раздели 6 - 7. Задача 4: раздел 8. Задачи 5 - 6 и домашното: раздели 8 - 12. Ако раздел още не е минат в час, започнете със задачите преди него или първо прочетете раздела. Част, която не сте започнали, показва TODO, а не FAIL.type(x).__name__ е името на типа, като текст: "tuple", "list".backup с watch.copy() - backup = watch само би дало второ име на същия list (раздел 7). extend добавя няколко елемента с едно извикване; pop() маха последния елемент и го връща; sort(reverse=True) сортира от най-големия. Методите променят watch и връщат None: пишете watch.sort(), а не watch = watch.sort() (раздел 6).record[:-1] е записът без последния му елемент (нов tuple), (40,) е tuple с един елемент (раздел 8), а + ги съединява.total = 0.0 и три празни lists.both_currencies - в цикъла съберете клиентите на кредитите в EUR в един set, а на тези в USD - в друг; след цикъла пресечете двата set-а с &.file.readline() прескача заглавния ред, после fields = line.strip().split(",") в цикъла. Колоните са в реда на заглавния ред (задача 6 ги изброява; страницата примерни данни също): fields[0] е първата.loans.append((fields[0], ..., float(fields[7]), int(fields[10]))) - обърнете внимание на двата чифта скоби (раздел 8).clients.csv и запазвайте региона, когато клиентът е в този set.| Тема | Запомнете |
|---|---|
| Поредици | list, tuple, range, str: подредени; len, in, +, *, min, max, count, index |
| Индекси | от 0; -1 е последният; грешен индекс е IndexError |
| Slices | s[start:stop:step], stop не е включен; s[:3] първите 3, s[-3:] последните 3, s[::-1] обърнат, s[:] копие |
| Lists | [...], mutable; append, extend, insert, pop, remove, sort; методите връщат None |
| Сортиране | lst.sort() променя list-а; sorted(x) връща нов list |
| Референции | b = a е същият list с две имена; копие: a[:], a.copy(), list(a) |
| Tuples | (...), immutable, прави го запетаята: (99,); разопаковане a, b, c = t, _ за стойност, която не ви трябва; записи |
range | range(start, stop, step), stop не е включен; малък в паметта |
| Sets | {...} / set(), уникални, неподредени; add, discard; бърз in; отпечатване със sorted() |
| Операции със sets | | е UNION от SQL, & е INTERSECT, - е EXCEPT; ^ симетрична разлика; <= подмножество |
03-lists-tuples-sets/homework.py (в homework repository): моментна снимка на портфейла от loans.csv - кредитите като list от tuples, петте най-големи експозиции, различните продукти, клиентите с ипотечен и потребителски кредит едновременно и регионите на клиентите в stage 3. Всяка проверка трябва да отпечата OK.names.py пита колко имена ще въведе потребителят, чете ги с input() в цикъл в list и ги отпечатва сортирани, без повторения, и колко са били повторенията."Racecar"). Проверете го със slice, за думи, въведени от потребителя.03-lists-tuples-sets/notebook.ipynb - кратки допълнителни задачи по днешните теми в Jupyter notebook, всяка с клетка за проверка. Отворете го във VS Code и изберете kernel-а .venv.del, tuples и поредици, sets)copyСледващото занятие: функции - собствен def, параметри и върнати стойности и защо функцията е версията на SAS macro в Python.